Économiser des tokens Claude Code : ce que cinq mois de pratique m'ont appris
Pour économiser des tokens Claude Code, j'ai d'abord regardé ce que Claude écrit. Erreur : 97,5 % de ma consommation depuis juin, c'est du contexte relu. Huit gestes datés et chiffrés, les rechutes, ce qui n'a pas marché, et la checklist.
5 novembre 2026·Julien Guézennec·11 min de lecture
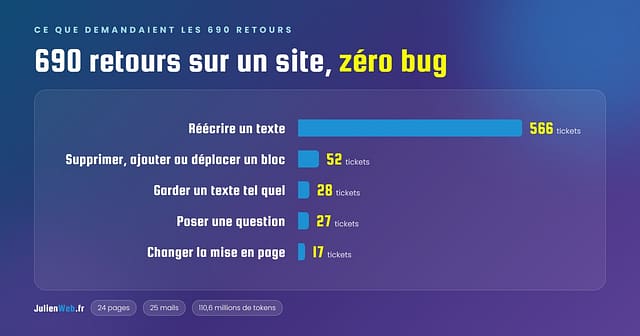
Pour économiser des tokens Claude Code, j'ai d'abord cherché du côté de ce que Claude écrit. Mauvaise piste. Le 15 octobre, j'ai compté tous mes échanges depuis le 10 juin : 21,8 milliards de tokens, dont 97,5 % de lectures de cache. Ce que Claude a réellement écrit pèse 85,8 millions, moins de 0,4 % du compteur. J'ai raconté ce comptage dans les 690 retours d'un client sur son site, je n'y reviens pas.
La leçon tient en une phrase : ce qui coûte, c'est ce que Claude relit à chaque tour. Son fichier d'instructions, l'index de sa mémoire, la liste de ses skills, les outils branchés. Tout ça repart à chaque message, même pour répondre « ok ».
Voici les gestes qui ont marché chez moi, dans l'ordre où je les ai faits, avec leurs chiffres. Et ceux qui n'ont servi à rien.
Économiser des tokens Claude Code commence par ce qu'il relit
Avant de couper quoi que ce soit, il faut savoir ce qui pèse. Claude Code charge d'office, avant votre premier message :
- le
CLAUDE.mdglobal (vos règles pour tous les projets) ; - le
CLAUDE.mddu projet ; - l'index de la mémoire automatique (
MEMORY.md) ; - la liste des skills disponibles, nom et description de chacun ;
- les outils des serveurs MCP et des extensions activées.
La page de la documentation sur les coûts explique d'où viennent ces tokens. Dans une session, /context montre leur répartition. Pour mes fichiers, je mesure à la louche : wc -c CLAUDE.md, puis 4 caractères pour un token. Grossier, mais suffisant pour voir qu'un fichier de 52 Ko pèse environ 13 000 tokens.
Le cache réduit le prix de ces relectures, il ne les supprime pas : une lecture de cache est facturée un dixième d'une entrée normale, et le cache s'efface après 5 minutes sans message, d'après la documentation d'Anthropic sur le cache. Et sur un abonnement, c'est la fenêtre de quota qui se vide, pas une facture. Le 3 octobre au soir, puis le 4, j'ai touché la limite avant d'avoir fini ma journée. C'est ce qui m'a fait mesurer.
Gain n°1 : le CLAUDE.md contient des règles, pas un journal
Mon CLAUDE.md de projet faisait 52,4 Ko le 3 septembre. En le relisant, j'ai compris pourquoi : chaque fin de session y ajoutait son récit. « Le 12 avril, telle corruption ; le 3 juin, tel correctif. » Un fichier d'instructions qui raconte sa vie.
La règle que j'ai écrite en tête du fichier, depuis : « relu à chaque tour de chaque session : règles et pointeurs, jamais de journal ». Un sujet tient en une ligne, avec un lien vers le document qui porte le détail. Le récit part dans une archive datée, qui n'est jamais chargée.
| Fichier | Avant | Après |
|---|---|---|
CLAUDE.md du studio (3 septembre) | 52,4 Ko | 22,6 Ko |
CLAUDE.md du studio (15 octobre) | 28,7 Ko | 11,6 Ko |
CLAUDE.md global (28 septembre) | 16,3 Ko | 6,5 Ko |
CLAUDE.md d'un projet client (15 octobre) | 106 Ko | 18 Ko |
Le dernier, c'est le cas le plus parlant : 106 Ko, environ 30 000 tokens relus à chaque message, pour un projet où l'on échangeait des dizaines de messages par soirée.
Gain n°2 : compacter sans rien perdre
Couper un fichier d'instructions fait peur, et à raison : une règle disparue, c'est une erreur qui revient. J'ai donc outillé le contrôle :
- Archiver l'ancien fichier tel quel, dans
notes/avec la date. Il n'est plus chargé, mais il existe. - Verser avant de couper. Une règle qui ne vit que dans le
CLAUDE.mdpart d'abord, mot pour mot, dans le document qui la porte. LeCLAUDE.mdgarde une phrase et le lien. - Chercher les orphelins à la machine. Un script extrait de l'archive tous les noms de fichiers, de scripts et de fiches mémoire, puis vérifie que chacun existe encore quelque part dans les fichiers vivants.
Sur le projet client à 106 Ko, le contrôle a trouvé 4 orphelins sur 192 éléments. Sur le studio, 0 sur 129. Quatre règles que j'aurais perdues sans le savoir, remises en pointeur en deux minutes.
Gain n°3 : un plafond, sinon ça regrossit
C'est le piège que personne ne mentionne. Un CLAUDE.md compacté regrossit tout seul. Le mien est passé de 20 à 31,6 Ko en cinq semaines. Le global, de 6,5 Ko le 28 septembre à 11,8 Ko aujourd'hui : +82 % en cinq semaines, une règle utile à la fois.
Deux parades :
- le plafond écrit en tête du fichier (15 Ko pour le studio), pour que Claude le lise avant d'ajouter une ligne ;
- le plafond contrôlé en fin de session : si
wc -cdépasse, on compacte avant de clore. C'était justement la routine de fin de session qui empilait les récits.
Gain n°4 : couper ce qui ne sert jamais
Le 3 septembre, en fouillant ~/.claude.json, j'ai trouvé les compteurs d'usage de chaque extension (pluginUsage). Six paquets de skills installés d'office, jamais appelés une seule fois depuis le 8 juin. Leur liste partait pourtant à chaque message.
Je les ai coupés dans les réglages, avec "enabledPlugins": { "<paquet>@inline": false }, et j'ai récupéré quelques milliers de tokens par tour. Mes propres notes donnent 3 000 à un endroit et 10 000 à un autre, et je n'ai pas remesuré : je garde le chiffre bas.
Deux leçons au passage, pour économiser des tokens Claude Code sans casser l'outil :
- décider sur les compteurs, jamais au feeling : j'aurais coupé l'extension PDF, qui servait 25 fois ;
- raccourcir les descriptions de skills plutôt que les skills : la description est relue à chaque tour, le corps seulement quand le skill sert. Sur un projet client, en mai, passer une description de 1 200 à 200 caractères et faire pareil sur les autres a fait passer la base de 16 000 à 13 800 tokens (−14 %).
Gain n°5 : une mémoire triée, et une seule
La mémoire automatique de Claude Code garde un index (MEMORY.md) chargé à chaque session, décrite dans la page sur la mémoire. Chez moi, il est lu jusqu'à 200 lignes ou 25 Ko environ, et le mien flirte avec 19 Ko. Je l'ai recompacté à la main huit fois.
J'ai fini par sortir de l'index tout ce qui est clos (article publié sans suite, projet terminé) vers un dossier archive/ qui a son propre sommaire et n'est jamais chargé. Une fiche qui redevient active revient dans l'index.
Et une découverte du 24 octobre, qui m'a fait rire jaune : Claude Code range la mémoire par dossier de travail. Chaque copie de travail d'un même projet avait donc sa propre mémoire, qui ignorait les autres. Le studio en avait trois : 207, 38 et 34 fiches. Des règles apprises dans une session n'existaient pas dans la voisine. Réglé par des liens de dossier vers une mémoire unique.
Gain n°6 : faire lire par un modèle moins cher
Quand Claude doit lire beaucoup (fouiller un dossier, inventorier des fichiers), il le fait dans un sous-agent. Par défaut, le sous-agent hérite souvent du modèle de la session, donc du plus cher.
Depuis le 25 octobre, j'ai deux sous-agents à modèle fixé :
lecteur: Sonnet, lecture seule, pour toute recherche ou tout inventaire ;relecteur: Opus, pour relire un livrable avec un autre regard que celui qui l'a écrit.
Pour cet article, deux lecteur ont fouillé mes notes en parallèle et m'ont rendu une page chacun au lieu de dizaines de fichiers bruts. Je n'ai pas de mesure avant/après de la facture : le gain se voit dans la fenêtre de quota du soir, qui tient de nouveau jusqu'au bout.
Gain n°7 : moins de sessions, plus utiles
Le 24 octobre, j'ai compté : 221 sessions sur 344 faisaient cinq tours ou moins. Chacune repayait le chargement complet du contexte pour une question à trois messages. Le 5 octobre, avec sept ou huit sessions ouvertes en parallèle, ma connexion 4G a saturé.
La règle depuis : une micro-tâche (moins de trois fichiers touchés) se fait dans la session du jour du projet, pas dans une neuve. Trois sessions en parallèle au plus.
Gain n°8 : une règle tenue par la machine plutôt qu'écrite
Une règle écrite dans le CLAUDE.md coûte des tokens à chaque tour, et Claude peut l'oublier. Un hook, petit script lancé avant ou après une action, la tient sans rien coûter au contexte. Le mien vérifie une dizaine de règles (pas de mot de passe en clair dans une commande, une seule question à la fois, etc.) en 57 millisecondes par appel.
Mais un hook peut mourir en silence. Deux exemples vécus :
- mon hook de démarrage mettait 7,2 secondes, pour un délai maximal de 5. Il a été annulé dans 810 transcripts sur 839, pendant des semaines, sans un message. Coupable : une commande git lancée 81 fois au lieu d'une. Corrigé, il tourne en 0,1 seconde ;
- mon garde anti-tournures IA sur les brouillons Gmail n'a jamais tiré avant le 11 septembre : son filtre attendait le nom court de l'outil, Claude Code lui passait le nom long.
Un hook se teste avec un cas qui doit le déclencher. Le voir ne rien signaler ne prouve rien.
Ce qui n'a pas aidé à économiser des tokens Claude Code
- Graphify, un graphe de dépendances censé réduire le contexte. Il ne retire rien de ce qui est relu à chaque tour, il coûte des tokens à construire et périme à chaque modification. Abandonné le 3 septembre.
- Le mode « caveman », qui fait répondre Claude en style télégraphique. L'économie sur la sortie est réelle, mais la sortie ne pèse que 0,4 % de ma consommation. Et les réponses devenaient illisibles sur les longues sessions. Désactivé en juin.
- Forcer tous les sous-agents sur Sonnet par une variable globale. Ça rétrograde aussi, en silence, les sous-agents qui conçoivent. J'ai préféré des agents nommés.
- Mesurer en fin de longue session. Après une compaction automatique du contexte, les chiffres sont faux. On mesure sur une session fraîche.
La checklist pour économiser des tokens Claude Code
- Mesurer d'abord :
/context,wc -csur lesCLAUDE.mdetMEMORY.md. - Le
CLAUDE.mdcontient des règles et des liens, pas de récit. L'ancien part en archive datée. - Contrôler les orphelins à la machine avant de supprimer quoi que ce soit.
- Écrire un plafond en tête du fichier et le vérifier en fin de session.
- Couper les extensions à zéro usage, d'après les compteurs.
- Raccourcir les descriptions de skills, garder le détail dans leur corps.
- Sortir de l'index mémoire ce qui est clos. Une seule mémoire par projet.
- Faire lire par un sous-agent Sonnet en lecture seule.
- Regrouper les petites demandes dans la session du jour.
- Tenir les règles critiques par un hook, et tester le hook avec un cas qui doit le déclencher.
Pour la suite, j'ai ajouté le 5 novembre quatre règles tirées des prompts de la Gueznet n°10 et des trois numéros précédents (n°7, n°8, n°9) : toute boucle a une condition d'arrêt chiffrée, on ne passe au modèle supérieur qu'après deux échecs identiques, pas de « terminé » sans tests passés, et une deuxième relecture reprend le même relecteur. Je mesurerai dans un mois.
J'ai aussi trié ces quatre numéros : les 14 prompts qui servent vraiment au quotidien avec Claude, prêts à copier, tiennent en quatre pages.
Questions fréquentes
Est-ce que /compact suffit pour économiser des tokens ?
Non. /compact résume la conversation en cours, il ne touche pas au CLAUDE.md, à la mémoire ni à la liste des skills, qui repartent tels quels au tour suivant. C'est utile en fin de longue session, pas pour alléger la base.
Quelle taille viser pour un CLAUDE.md ?
Je me suis fixé 15 Ko pour le studio, qui a une centaine de scripts et une quarantaine de skills. Le CLAUDE.md d'un petit site client tient chez moi en 1,5 Ko. Le chiffre compte moins que la règle : si une ligne raconte une histoire, elle n'a rien à faire là.
Un token, c'est quoi déjà ?
Un morceau de mot, environ quatre caractères en français. La définition et 49 autres mots sont dans le glossaire de l'IA.
Et après
Économiser des tokens Claude Code, chez moi, ça a surtout voulu dire arrêter de faire relire à Claude ce qui ne lui servait pas. Le reste (réponses courtes, modèle moins cher) compte, mais beaucoup moins que je ne le croyais.
L'outillage complet qui tourne autour est décrit dans mes skills Claude Code de freelance solo. Si vous voulez installer Claude Code dans votre petite équipe sans passer cinq mois à découvrir tout ça, c'est ce que je fais en accompagnement IA pour les PME.
Et si vous avez mesuré autre chose chez vous, écrivez-moi : je compléterai la liste.
JG
Lire aussi
- Retours client site web : 690 tickets, zéro bug : le comptage complet des tokens, mois par mois · octobre 2026
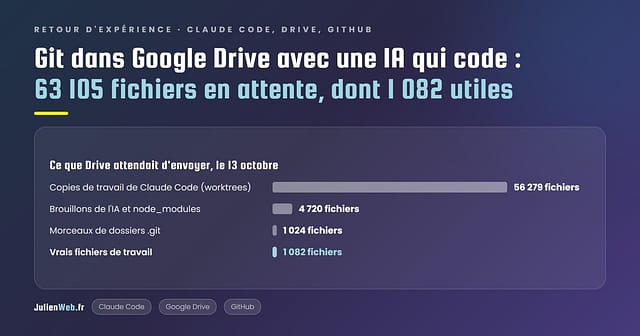
- Git dans Google Drive avec une IA qui code : l'autre face des copies de travail de Claude Code · octobre 2026
- 60 skills Claude Code pour un freelance solo : les skills dont les descriptions pèsent à chaque tour · juillet 2026
- Glossaire IA : 50 mots : token, contexte, skill, sous-agent · septembre 2026
- La Gueznet IA, prompts n°10 : sous-agents relecteurs, /goal à arrêt mesurable · octobre 2026
Claude Code dans votre équipe, sans y laisser cinq mois
Installer Claude Code dans une petite équipe, écrire des instructions qui tiennent sans regrossir, faire lire les bons modèles au bon moment : c'est ce que je fais en accompagnement IA, sur vos projets et pas sur des exemples.
// julienweb.fr/ressources-ia
Ressources IA : sept documents libres pour débuter
Les supports de ma formation « Initiation à l'IA », à lire en ligne ou à télécharger en PDF : les huit gestes, l'antisèche des prompts, les prompts IA photo, le glossaire, 159 usages, l'annuaire des outils testés et l'aide-mémoire Claude.
Pour l'appliquer dans votre entreprise : la formation IA pour TPE et PME, sur vos tâches réelles, ou un consultant IA pour automatiser ce qui peut l'être.
Voir les sept documents →