IA · le tri de la semaine
Jev IA : le modèle qui ne parle pas, il décide
Un choix et une probabilité, jamais une phrase. Ce qui est vérifié sur Jev au 25 septembre 2026, ce que TypeSafe annonce sur ses propres mesures, et ce que X a inventé autour.
25 septembre 2026·Julien Guézennec·16 min de lecture
Chaque mois, je trie ce que je mets de côté pour La Gueznet IA. Cette semaine, sur 27 posts, 7 parlent de Jev, un nouveau modèle d'IA. Des fils « 10 dépôts GitHub à connaître », des « envoie ce prompt Jev à ton IA, tu me remercieras », un « Sol pense, Jev décide, Grok exécute »... Quand un nom prend un quart de ma veille en huit jours, je vais voir ce qu'il y a dessous.
Deux choses à savoir avant de lire. Je paie Anthropic tous les mois et je travaille avec Claude tous les jours. Je n'ai aucune part chez TypeSafe, mais j'ai un concurrent de Jev ouvert dans l'onglet d'à côté. Et je n'ai pas testé Jev. Ce qui suit vient de la documentation officielle, de la presse et de l'API de GitHub, lues le 25 septembre 2026, puis relues le 1ᵉʳ octobre : OpenAI a annoncé entre-temps sa propre API de décisions, et j'ai ajouté trois sections datées plus bas. Je trie en trois colonnes, comme pour les dangers de l'IA : ce qui est constaté, ce qui est annoncé, ce qui est cru.
Jev IA : un modèle qui répond par un chiffre, jamais par une phrase
Jev IA, c'est le premier modèle de TypeSafe AI, une société de San Francisco. Elle est sortie de l'ombre le 15 septembre 2026 avec 40 millions de dollars levés, un tour mené par le fonds DCVC. À sa tête, Diogo Almeida, passé par OpenAI, présenté comme l'un des inventeurs du RLHF, la méthode d'entraînement qui a fait ChatGPT.
Ce qu'il fait tient en une ligne : du texte en entrée, des décisions typées en sortie. Vous lui donnez une situation (un mail client, un ticket, l'état d'un agent au milieu d'une tâche) et des questions fixées à l'avance. Il ne rédige pas de réponse. Il coche, il note, il tranche, et il dit à quel point il est sûr.
La documentation ne propose que trois sortes de questions :
- Choice : choisir une option dans une liste que vous avez écrite (« quel service doit traiter ce ticket : facturation, technique ou commercial ? »).
- Score : placer la situation sur une échelle que vous avez décrite (« client calme, agacé mais poli, furieux »).
- Noul : dire si un énoncé est vrai, avec une valeur entre 0 et 1 (« ce message exprime-t-il de l'urgence ? »).
C'est tout. Pas de résumé, pas de traduction, pas de brouillon de réponse. Jev est une IA qui ne sait pas écrire une phrase, et c'est le principe.
Système 1, Système 2 : ce que Kahneman vient faire là
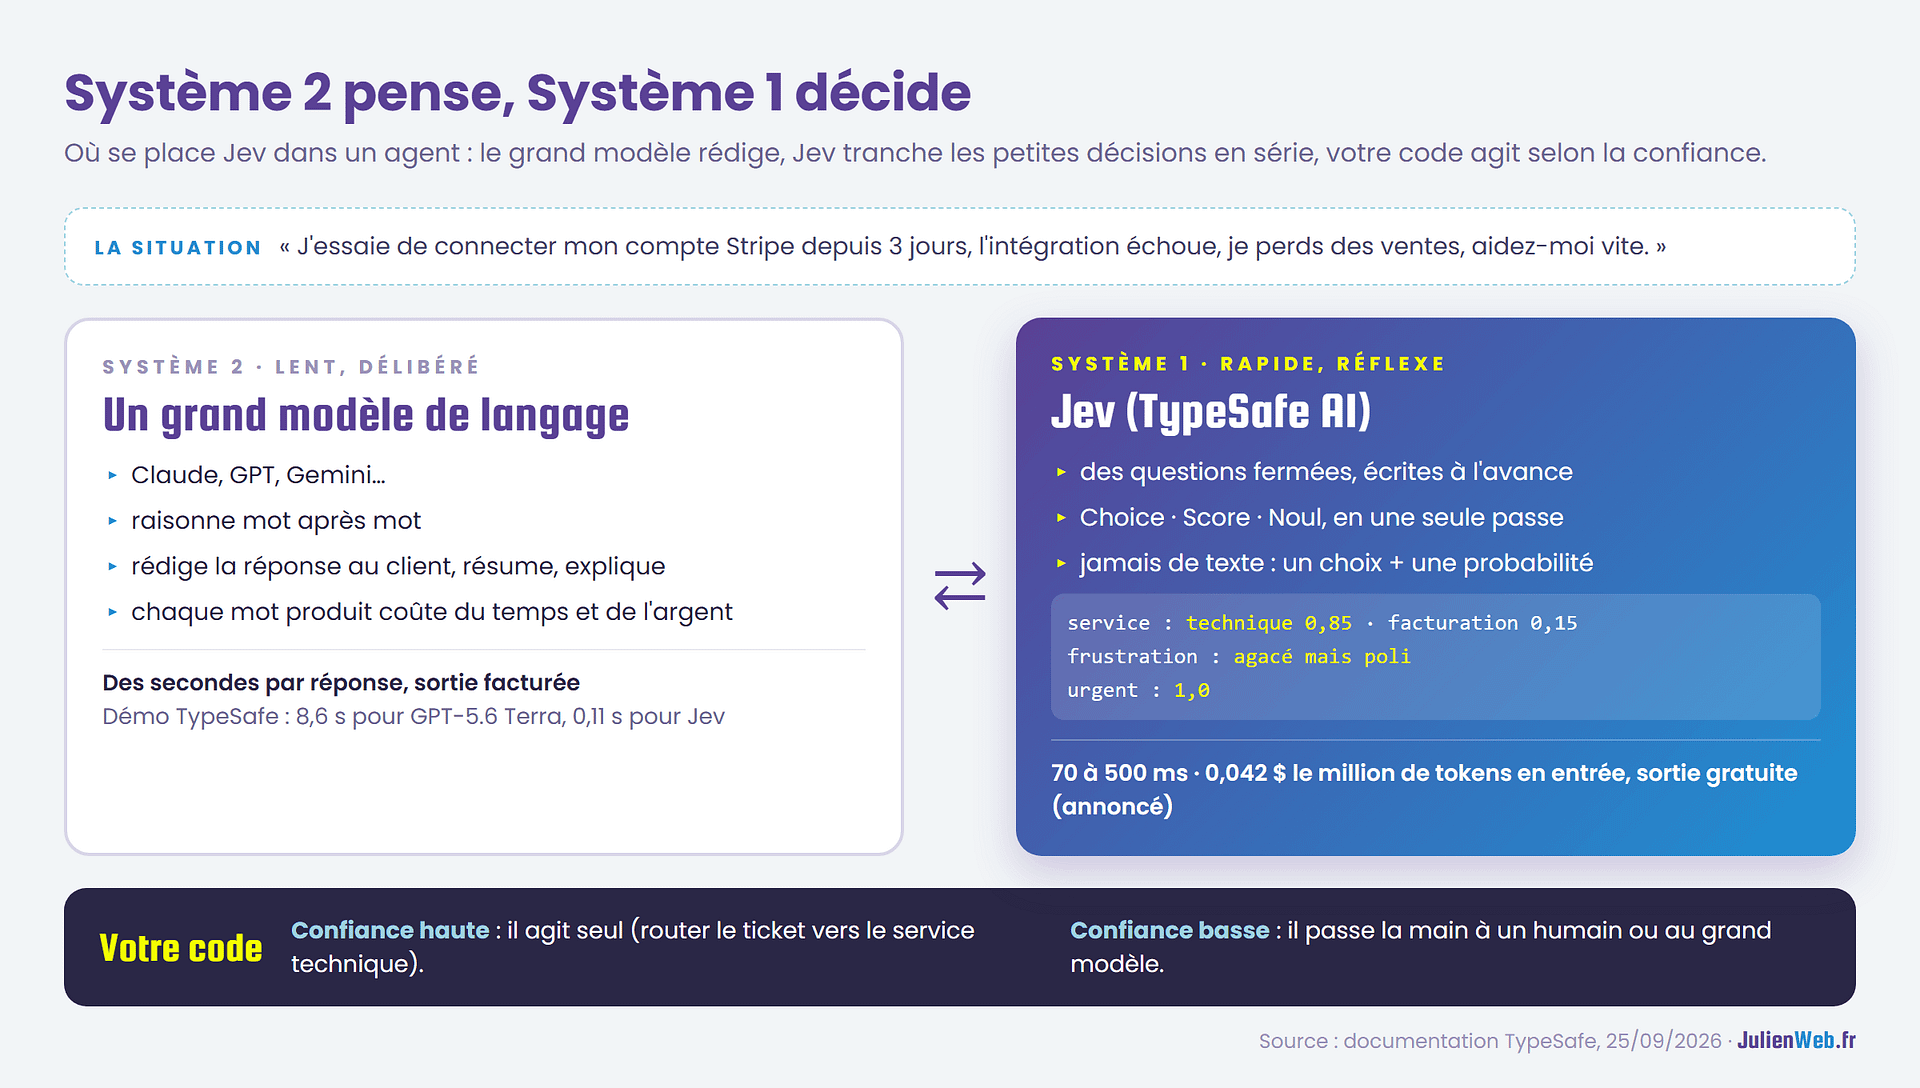
TypeSafe appelle son IA Jev un « System One model ». La référence vient de Daniel Kahneman, le psychologue prix Nobel d'économie. Il distinguait deux façons de penser. Le Système 1 est rapide et automatique (reconnaître un visage en colère, freiner devant un obstacle). Le Système 2 est lent et délibéré (poser une multiplication, peser un contrat).
Les modèles qu'on utilise tous, ChatGPT, Claude, Gemini, sont du côté du Système 2 : ils raisonnent mot après mot, et chaque mot coûte du temps et de l'argent. Or un agent passe une bonne partie de sa journée à prendre des décisions de Système 1. Est-ce que cette commande est dangereuse ? Est-ce que ce bout de contexte sert encore ? Faut-il un gros modèle pour cette tâche ou un petit suffit ? Aujourd'hui, on pose ces questions au gros modèle. Il répond en prose, et on relit sa prose avec du code pour en tirer un oui ou un non.
TypeSafe propose de confier le réflexe à un modèle fait pour ça, et garder le gros modèle pour réfléchir. Un tweet de la semaine le résume mieux que le communiqué : « Sol pense. Jev décide. »
À quoi ressemble une question posée à Jev IA
Voici l'exemple de la documentation officielle, traduit. Un client écrit « J'essaie de connecter mon compte Stripe depuis trois jours, l'intégration échoue, je perds des ventes, aidez-moi vite ». On pose trois questions en une seule requête :
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated the customer appears",
      "criteria": ["Calm, just stating facts", "Frustrated but civil", "Very angry, strong language"]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
Et la réponse, raccourcie :
{
  "model": "jev-1.13.0",
  "answers": {
    "department": { "choice": "technical", "confidence": 0.78,
                    "probabilities": { "technical": 0.85, "billing": 0.15, "sales": 0.0 } },
    "frustration": { "score": 1.0, "confidence": 1.0 },
    "is_urgent": { "noul": 1.0 }
  },
  "usage": { "input_tokens": 392, "output_tokens": 65 }
}
Ça se lit ainsi. Service technique (85 %, mais 15 % de chances que ce soit la facturation, parce que Stripe, c'est aussi du paiement), client agacé mais poli, message urgent. Votre code n'a rien à interpréter. Il lit technical, il route le ticket. S'il lit une confiance de 0,4, il le passe à un humain.
Le calcul qui fait tourner les têtes : 392 tokens en entrée, facturés 0,042 dollar le million, sortie gratuite. Un million de tickets comme celui-là coûtent environ 16 dollars.
Quand il dit 80 %, ça doit arriver 8 fois sur 10
La vraie nouveauté n'est pas la vitesse, c'est le chiffre qui accompagne la réponse. Un grand modèle de langage qui vous dit « je suis sûr à 90 % » n'a rien mesuré : il a écrit la phrase qu'un humain sûr de lui écrirait. Jev est entraîné avec une méthode maison, le RLCD (Reinforcement Learning for Calibrated Decisions). Elle récompense des probabilités calibrées : sur mille décisions annoncées à 80 %, environ 800 doivent être justes.
C'est ce qui rend le modèle utilisable par du code. La page Confidence de la documentation le dit sans détour : une confiance faible veut dire « n'agis pas, passe la main à un humain ». Des seuils différents selon le coût de l'erreur : on laisse passer un tri de mails à 0,7, on ne bloque pas une commande de production sans 0,95.
Le 18 septembre, un CTO cité par TechCrunch ne retenait que ça : Jev est le seul, selon lui, à rendre « une vraie probabilité ».
Constaté, annoncé, cru : le tri
Ce qui est constaté
- Le prix et les limites sont publiés. Sur la page des modèles : Jev 1.13, 0,042 dollar le million de tokens en entrée, sortie gratuite, 64 000 tokens de contexte. Texte seulement : ni image, ni son, ni vidéo. Le débit autorisé a déjà changé : 1 200 requêtes par minute le 25 septembre, 40 par seconde le 1ᵉʳ octobre.
- Rien n'est ouvert. Licence propriétaire, pas de poids téléchargeables, pas de papier technique, pas d'architecture publiée (fiche Wikipedia)). On ne peut pas vérifier comment c'est fait, seulement ce que ça rend.
- La demande a débordé l'offre. TechCrunch rapporte que TypeSafe a perdu un temps la capacité de servir son API. La documentation prévient encore que les limites « changent sans préavis », le temps que « de gros contrats de GPU arrivent ». Les inscriptions, suspendues plusieurs jours, ont rouvert le 27 septembre sans les 5 dollars de crédit offerts au départ.
- L'écosystème a poussé en neuf jours. Les dix dépôts GitHub du fil le plus partagé existent tous, créés à partir du 16 septembre. browser-use/jev-ultrafast, un agent de navigation qui choisit son prochain clic avec Jev, compte 20 011 étoiles le 25 septembre. fast-jev-compaction, un plugin Claude Code qui laisse Jev décider quoi garder quand la conversation déborde, en a 6 778. jev-router envoie chaque tâche de Claude Code au modèle le moins cher capable de la faire.
- Deux retours indépendants, publiés. Chez Vercel, un classifieur vérifie la dangerosité des commandes. Passé de ChatGPT Luna 5.6 à Jev, il répond 5 à 18 fois plus vite, et plus juste. Chez Bryo AI, sur le tri de mails professionnels, Gemini était un peu plus juste que Jev, mais 10 à 20 fois plus cher. Le gain existe, il se paie parfois d'un peu de précision.
Ce qui est annoncé (par TypeSafe, sur ses propres mesures)
- « 193,6 fois plus rapide, 444,6 fois moins cher » que les grands modèles, sur des workflows choisis par TypeSafe. Le billet de lancement reconnaît lui-même que c'est « le haut de la fourchette ». Contre un petit modèle déjà bon marché, le retour de Bryo donne plutôt 10 à 20.
- « 238 fois moins cher que Claude Fable 5.1. » Le calcul tient sur le papier, parce qu'on compare un modèle qui ne rédige rien à un modèle fait pour rédiger. C'est comme dire qu'un interrupteur consomme moins qu'un four.
- « Zéro hallucination. » L'IA Jev n'invente pas de phrase, puisqu'elle n'en écrit pas. Mais une décision à 85 % reste fausse une fois sur sept. The Register fait la même remarque : une réponse structurée peut être fausse. Ne pas halluciner du texte, ce n'est pas avoir raison.
Ce qui est cru (sur X, cette semaine)
- « Send this Jev prompt to any LLM. » Deux des sept posts de ma veille vendent un prompt à coller dans ChatGPT pour « installer Jev » et « optimiser votre setup ». Jev IA ne se lance pas depuis un chat : c'est une API payante, derrière une liste d'attente, qui ne répond qu'à des questions fermées. Un prompt pour un modèle qui ne converse pas, c'est l'appât parfait : on ne peut pas vérifier que ça ne marche pas.
- « 3 412 prospects, 20 472 décisions en 15,7 secondes pour 0,41 dollar. » Chiffre d'un tiers, sans code ni journal. Plausible vu le prix affiché, invérifiable tel quel.
- « Jev founder Diogo Amogo. » Il s'appelle Almeida. Le post a été repris tel quel.
Un détail que presque personne n'a relevé : d'après The Register, le nom vient de William Stanley Jevons, l'économiste du paradoxe de Jevons. Au XIXᵉ siècle, il avait observé que des machines à vapeur plus économes en charbon faisaient... monter la consommation de charbon. Une start-up vend des décisions à prix cassé et se baptise du nom de celui qui a prouvé que l'efficacité fait exploser la facture totale. Au moins, on ne pourra pas dire qu'on n'était pas prévenu.
CLM-8B : le concurrent ouvert, sorti huit jours après
Le 23 septembre, une équipe liée au laboratoire Hazy Research de Stanford a publié CLM-8B, un autre « modèle Système 1 ». Il est annoncé jusqu'à 9 fois plus rapide que Jev, à performance comparable. La différence qui compte pour nous : ses poids sont téléchargeables. Il repose sur un modèle Qwen3 de 8 milliards de paramètres, avec une autre méthode (il compare la situation à chaque action possible et garde la plus proche).
Au même moment, un développeur indépendant publiait SemIf-OpenJev, des « si » sémantiques qui tournent sur une carte graphique de joueur, et qui précise « non affilié ». Huit jours après le lancement, l'idée est déjà copiée en ouvert. C'est plutôt bon signe pour l'idée, moins pour les 200 millions de valorisation.
Laya et Kev : deux autres modèles ouverts
Au 1ᵉʳ octobre, deux autres projets ont dépassé CLM-8B en audience. Les deux sont sous licence Apache 2.0, donc utilisables dans un produit commercial.
- Laya (29 673 étoiles). Un petit modèle de 421 millions de paramètres, qui répond aux trois mêmes sortes de questions et se branche à la place de Jev. Il tourne sans carte graphique. Ses auteurs écrivent eux-mêmes les limites : 512 tokens de contexte pour la version anglaise, et un modèle « trop sûr de lui » tant qu'on n'a pas réglé ses probabilités sur ses propres données.
- Kev (8 158 étoiles). Une famille de quatre tailles bâtie sur les modèles Qwen, de 0,8 à 27 milliards de paramètres. Elle accepte le kit de développement de TypeSafe sans changer une ligne. D'après son auteur, la plus grosse version arrive à un point de Jev (0,851 contre 0,857) sur des sources nouvelles, mais reste loin sur les questions de connaissances difficiles (0,675 contre 0,840), et il lui faut une carte graphique de 80 Go.
Sur les réseaux, Kev est présenté comme tiré de « l'architecture publiée par Jev ». C'est faux. TypeSafe n'a toujours rien publié. Kev s'appuie sur l'enquête d'un tiers, qui a reconstitué le fonctionnement probable du modèle à partir de la documentation et de milliers d'appels.
Mise à jour du 1ᵉʳ octobre : OpenAI copie Jev IA
Le 29 septembre, à sa conférence pour développeurs, OpenAI a annoncé une « Decisions API ». Le récapitulatif officiel la décrit en une phrase : elle utilise le modèle Luna pour classer des entrées, router des requêtes ou choisir une action parmi des réponses fixées à l'avance. C'est le principe de Jev IA, deux semaines après son lancement. TechCrunch titre sans détour sur un « clone de Jev ».
Ce qu'on sait tient en peu de lignes. L'API est en aperçu limité. Je n'ai trouvé ni prix ni documentation au 1ᵉʳ octobre. Sam Altman promet un modèle « extrêmement rapide » qui garde la lecture d'images et un large choix de langues, deux points faibles de Jev. Rien, dans ce que j'ai lu, ne dit que ses probabilités sont calibrées. Or c'était la vraie nouveauté de Jev, et TechCrunch pose la même question.
Diogo Almeida a plaisanté sur « le début de la guerre des clones ». Il y voit le signe que cette façon de construire est la bonne. Il a sans doute raison sur l'idée. Pour sa société, c'est une autre histoire : quand le fournisseur du gros modèle vend aussi le petit, il reste peu de place entre les deux.
Et Claude ? Anthropic n'a rien annoncé
Je rappelle que je paie Anthropic. Au 1ᵉʳ octobre, Anthropic n'a rien annoncé qui ressemble à Jev. Une partie de l'idée tourne pourtant déjà chez eux. Dans Claude Code, le mode automatique fait juger chaque action par un classifieur avant de l'exécuter. Anthropic l'a décrit en mars : un premier filtre qui répond d'un seul jeton, oui ou non, puis un raisonnement complet si le filtre s'inquiète. C'est du Système 1 suivi de Système 2, sans le nom. Ce qui manque, c'est le chiffre : le développeur ne reçoit pas de probabilité qu'il pourrait régler lui-même. Qu'Anthropic ouvre un jour cette brique aux développeurs est une hypothèse de ma part, pas une information.
Jev IA mesuré par d'autres que TypeSafe
Les premières mesures indépendantes sont sorties fin septembre. Une équipe de chercheurs a posé 346 009 questions à Jev sur 37 jeux de tests, pour moins de 10 dollars. Il bat un modèle ouvert de 27 milliards de paramètres sur 27 jeux, et ses probabilités de choix sont bien calibrées. Les oui/non le sont moins : le seuil de 0,5 tombe mal, il faut le régler. Une autre étude a trouvé un trou plus gênant. En calcul, quand la bonne réponse n'est pas dans la liste, Jev ne choisit « aucune de ces réponses » que 7 fois sur 100. Il prend une mauvaise réponse à la place. Ce sont deux prépublications, pas encore relues par des pairs.
Et pour une TPE, un indépendant ?
Pas directement, et ça ne presse pas. Jev ne vous aidera pas à écrire un devis, à répondre à un client ou à faire votre site. Il ne sert qu'à celui qui fait tourner du code qui décide en série. Un tri de tickets, un agent qui navigue, un contrôle avant d'exécuter une commande. Si vous n'avez rien de tout ça, vous n'avez pas besoin de Jev. Pour situer la différence entre discuter avec une IA et lui confier une tâche, j'en parlais dans IA agentique : la conversation ne suffit plus.
Il vous concerne indirectement : les outils que vous utilisez vont s'en servir. Un agent qui décide en 100 millisecondes pour quelques centimes, c'est un agent qu'on peut lancer mille fois par jour. Sur l'argent, c'est Jevons qui parle : le coût unitaire baisse, le volume explose.
Si vous développez, trois choses sont à lire avant de s'emballer :
- Le français n'est pas sa langue. La documentation l'écrit : l'anglais est la langue d'entraînement principale, les autres langues sont « gérées, mais pas aussi bien », à tester sur vos propres contenus avant de s'y fier. Pour un tri de mails de clients français, c'est le premier test à faire.
- Les données. L'IA Jev n'est pas entraînée sur les requêtes des clients, mais la conservation zéro (rien de stocké côté TypeSafe) est réservée aux clients entreprise. Un mail client est une donnée personnelle, confiée à une société américaine.
- Le modèle bouge sous vos pieds. L'alias
jev-latestchange de version sans prévenir. Si vous avez réglé vos seuils de confiance sur une version, figez son numéro.
Les pièges
- Confondre « rapide » et « juste ». Le match publié contre Gemini donne Gemini un peu plus juste. Jev IA gagne sur le prix et la vitesse, pas forcément sur la justesse.
- Poser une question floue. La documentation insiste : une question = une chose précise. « Ce client est-il content et solvable ? », ce sont deux Nouls, pas un.
- Prendre la confiance pour une garantie. Une probabilité calibrée dit combien de fois le modèle se trompe en moyenne, pas si celle-ci est la bonne.
- Croire les étoiles. 20 000 étoiles en neuf jours disent qu'un sujet est à la mode, pas qu'un code est solide. Lire le code avant de l'installer, surtout un plugin qui touche à votre Claude Code.
- Oublier la case « aucune de ces réponses ». Si la bonne réponse peut manquer dans votre liste, Jev risque d'en prendre une mauvaise plutôt que de refuser. À tester sur vos cas avant de lui faire confiance.
- Construire sur un service qui déborde. Inscriptions suspendues plusieurs jours, limites qui « changent sans préavis » : pas de production qui en dépend sans solution de repli.
Questions fréquentes
Qu'est-ce que Jev IA ?
Jev est un modèle d'intelligence artificielle de la société TypeSafe AI, lancé le 15 septembre 2026. Il ne produit pas de texte : il répond à des questions fermées (choisir, noter, dire vrai ou faux) avec une probabilité calibrée, en 70 à 500 millisecondes. Il sert à automatiser des décisions dans des logiciels et des agents.
Jev remplace-t-il ChatGPT ou Claude ?
Non. Jev IA ne rédige rien, ne résume rien, ne converse pas. Il complète un grand modèle de langage : le grand modèle réfléchit et rédige, Jev prend les petites décisions répétitives autour, plus vite et moins cher.
Peut-on utiliser Jev gratuitement ?
Non. Les inscriptions sont rouvertes à tous depuis le 27 septembre 2026, mais sans crédit offert. L'API de Jev IA est payante, 0,042 dollar par million de tokens en entrée, sortie gratuite. Il n'existe pas de version téléchargeable. Les alternatives ouvertes et gratuites s'appellent Laya, Kev et CLM-8B : elles se téléchargent et tournent sur votre propre machine.
Lire aussi
- La Gueznet IA n°8 : la veille de septembre 2026, 87 cartes, avant que Jev n'occupe le quart de la suivante. Septembre 2026.
- IA agentique : la conversation ne suffit plus : ce qui change quand on confie une tâche à une IA au lieu de discuter avec elle. Mars 2026.
- Dangers de l'IA : faut-il avoir peur ? : le même tri constaté, estimé, cru, appliqué à la peur de l'IA. Septembre 2026.
- Glossaire de l'IA et aide-mémoire Claude : cinquante mots, dont « token », « agent » et « RLHF », en deux feuilles à garder. Septembre 2026.
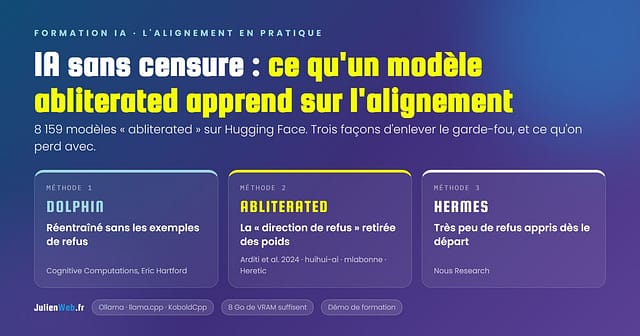
- IA sans censure : ce qu'un modèle débridé apprend sur l'alignement, et comment le faire tourner chez soi. Septembre 2026.
Les agents IA, dans votre activité ?
Sans liste d'attente ni jargon : ce que ces outils font vraiment, ce qu'ils ne font pas, et comment s'en servir. À Pantin ou en visio, la première heure est offerte.
// julienweb.fr/ressources-ia
Ressources IA : sept documents libres pour débuter
Les supports de ma formation « Initiation à l'IA », à lire en ligne ou à télécharger en PDF : les huit gestes, l'antisèche des prompts, les prompts IA photo, le glossaire, 159 usages, l'annuaire des outils testés et l'aide-mémoire Claude.
Voir les sept documents →